១. ព័ត៌មានទូទៅ
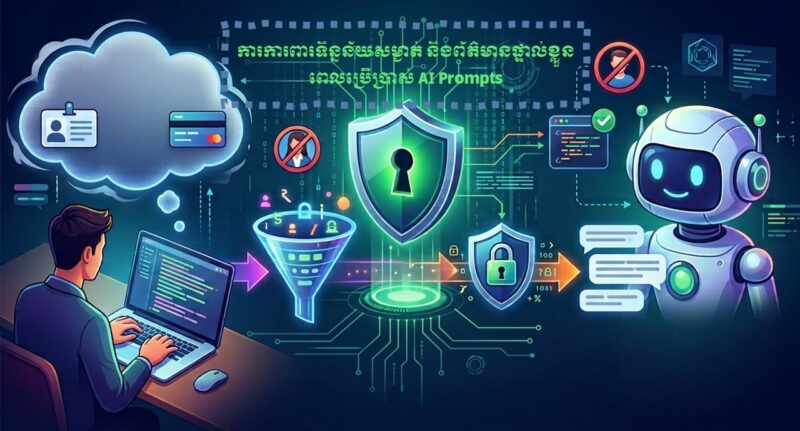
នាពេលបច្ចុប្បន្ន ការប្រើប្រាស់ប្រព័ន្ធបញ្ញាសិប្បនិម្មិត (Generative AI) ដូចជា ChatGPT, Gemini, Claude ឬ Microsoft Copilot ត្រូវបានអនុវត្តយ៉ាងទូលំទូលាយក្នុងការបំពេញការងារប្រចាំថ្ងៃ ដើម្បីបង្កើនផលិតភាព។ ទោះជាយ៉ាងណាក៏ដោយ ការប្រើប្រាស់ដោយខ្វះការប្រុងប្រយ័ត្ន និងការបញ្ចូលទិន្នន័យសម្ងាត់ចូលទៅក្នុង AI Prompts ដោយគ្មានការត្រួតពិនិត្យ អាចបង្កើតជាហានិភ័យសន្តិសុខសុវត្ថិភាពបច្ចេកវិទ្យា (Cybersecurity Risk) យ៉ាងធ្ងន់ធ្ងរ ទាំងកម្រិតបុគ្គល និងស្ថាប័ន។
២. ប្រភេទទិន្នន័យរសើបដែលមិនត្រូវបញ្ចូលក្នុង AI Prompt
- ការ Copy-Paste ទិន្នន័យមួយចំនួនចូលទៅក្នុង AI Tools អាចបណ្ដាលឱ្យបាត់បង់ការគ្រប់គ្រងលើទិន្នន័យ (Data Loss)៖
- ទិន្នន័យសម្ងាត់: លេខសម្ងាត់ (Passwords), API Keys, Tokens, Access Keys, ប្រភពកូដកម្មវិធី (Source Code), និងព័ត៌មានរចនាសម្ព័ន្ធ Server ឬ Database Credentials។
- ព័ត៌មានផ្ទាល់ខ្លួន: លេខអត្តសញ្ញាណប័ណ្ណ, លេខលិខិតឆ្លងដែន, លេខគណនីធនាគារ, កាតឥណទាន, និងកំណត់ត្រាសុខភាព ឬព័ត៌មានផ្ទាល់ខ្លួនរបស់អតិថិជន។
- ទិន្នន័យអាជីវកម្ម និងព័ត៌មានសម្ងាត់ក្រុមហ៊ុន (Proprietary Data): របាយការណ៍ហិរញ្ញវត្ថុមិនទាន់ផ្សព្វផ្សាយ, កិច្ចសន្យាពាណិជ្ជកម្ម, យុទ្ធសាស្ត្រប្រកួតប្រជែង, ឬឯកសារសម្ងាត់ផ្លូវច្បាប់។
៣. ហានិភ័យនៃការលេចធ្លាយ
- ការចងចាំពាក្យផ្ទាល់ និងការចងចាំពាក្យតាមតួ: ម៉ូឌែល AI ត្រូវការទិន្នន័យដ៏ច្រើនដើម្បីរៀន និងអភិវឌ្ឍ នៅពេលអ្នកបញ្ចូល Prompt ដែលមានព័ត៌មានរសើប ប្រព័ន្ធ AI អាចរក្សាទុកទិន្នន័យនោះដើម្បីយកទៅធ្វើ Data Training ឬ Fine-Tuning។ ប្រសិនបើ AI ចងចាំទិន្នន័យបែប Verbatim (ពាក្យដូចគ្នាទាំងស្រុង) នោះព័ត៌មានសម្ងាត់ដូចជា API Key ឬកូដកម្មវិធី អាចនឹងត្រូវបញ្ចេញ (Regurgitate) ទៅកាន់អ្នកប្រើប្រាស់ផ្សេងទៀតនៅពេលគេសួរសំណួរដែលមានបរិបទប្រហាក់ប្រហែលគ្នា។ យោងតាម OWASP Top 10 for LLM Applications ហានិភ័យនៃ Sensitive Information Disclosure (LLM02) ត្រូវបានចាត់ថ្នាក់ជាហានិភ័យចម្បងមួយដែលកើតមានញឹកញាប់បំផុត។
- បញ្ហា Shadow AI និងការរក្សាទុកទិន្នន័យលើ Server : រាល់ប្រវត្តិសន្ទនា (Chat History) ត្រូវបាន រក្សាទុកនៅលើ Infrastructure របស់ក្រុមហ៊ុនផ្តល់សេវា AI ក្នុងគោលបំណងធ្វើ Audit និង Monitor។ ប្រសិនបើគណនីរបស់អ្នកប្រើប្រាស់ត្រូវបានទម្លាយ (Account Takeover) តាមរយៈការវាយប្រហារ phishing ឬ session hijacking នោះជនខិលខូចនឹងអាចចូលមើលប្រវត្តិ Prompt ទាំងអស់ដែលមានទិន្នន័យសម្ងាត់។
- ការរំលោភលើច្បាប់ការពារទិន្នន័យ : ការបញ្ចូលទិន្នន័យផ្ទាល់ខ្លួនរបស់អតិថិជនទៅក្នុង AI Tools ដែលមិនមានកិច្ចសន្យាការពារទិន្នន័យច្បាស់លាស់ អាចជាការរំលោភបំពានលើបទបញ្ញត្តិការពារទិន្នន័យជាសកល ដូចជា GDPR ឬស្តង់ដារសុវត្ថិភាពទិន្នន័យហិរញ្ញវត្ថុ/សុខាភិបាល។
៤. វិធានការការពារសម្រាប់បុគ្គលិក និងអ្នកប្រើប្រាស់ទូទៅ
- ការអនុវត្ត Data Sanitization & Redaction: តែងតែលុប ឬជំនួសទិន្នន័យពិតប្រាកដ (ដូចជា ឈ្មោះ, លេខសម្ងាត់, IP Address, API Key) ដោយប្រើប្រាស់ទិន្នន័យគំរូ (Dummy Data / Placeholders) មុនពេលចុចផ្ញើ Prompt។
- កំណត់ Privacy & Data Controls (Opt-Out): ចូលទៅកាន់ Settings នៃ AI Tools នីមួយៗ ដើម្បីបិទមុខងារចែករំលែកទិន្នន័យសម្រាប់ Data Training (ឧទាហរណ៍៖ បិទ “Data Controls / Model Improvement” លើ ChatGPT ឬ Gemini)។
៥. សម្រាប់ស្ថាប័ន និងក្រុមហ៊ុន
- ការប្រើប្រាស់ Enterprise-grade AI Services: ជ្រើសរើសប្រើប្រាស់ AI Tools កម្រិត Enterprise (ដូចជា OpenAI Enterprise, Azure OpenAI System, ផ្អែកលើកិច្ចសន្យា Zero Data Retention) ដែលធានាថា Prompt របស់ក្រុមហ៊ុននឹងមិនត្រូវបានយកទៅ Train Model ជាដាច់ខាត។
- ដំឡើងប្រព័ន្ធ AI Gateway និង Enterprise DLP: អនុវត្តប្រព័ន្ធ Data Loss Prevention (DLP) និង AI Gateway ដើម្បីស្កេន ចាប់យក ឬបាំង (Block/Redact) រាល់ទិន្នន័យ sensitive មុនពេលវាត្រូវបានផ្ញើចេញពីបណ្តាញស្ថាប័នទៅកាន់ AI Web Application ខាងក្រៅ។
- បង្កើតគោលការណ៍ណែនាំ (Internal AI Policy): រៀបចំគោលការណ៍ណែនាំស្តីពីការប្រើប្រាស់ AI ឱ្យបានច្បាស់លាស់ និងរៀបចំការបណ្តុះបណ្តាលបង្កើនការយល់ដឹងដល់បុគ្គលិក ស្របតាមក្របខ័ណ្ឌ NIST AI Risk Management Framework (AI RMF)។
៦. ឯកសារពាក់ព័ន្ធ
- https://www.checkpoint.com/cyber-hub/what-is-llm-security/sensitive-information-disclosure/
- https://aurascape.ai/answers/owasp-top-10-llm-applications-security-checklist/
- https://orca.security/resources/blog/nist-ai-risk-management-framework-ai-rmf/
- https://privacy.gwu.edu/privacy-guidance-use-artificial-intelligence
- https://ico.org.uk/for-organisations/uk-gdpr-guidance-and-resources/artificial-intelligence/guidance-on-ai-and-data-protection/